专家混合(MoE)把模型拆成若干部件:多个各管一片知识的「专家」,外加一个路由器,每个输入只唤醒少数相关专家。4000 亿总参数的模型每个词元可能只激活 100 亿。
它的迷人等式是:巨人模型的知识量 + 中等模型的推理成本。这正是它统治 2025–2026 的原因:DeepSeek V3、GPT-4 与 Gemini 都是 MoE。
必须知道的技术细节:「总参数」与「每词元激活参数」是两个不同的数字;比较模型应看后者(以及数据质量),而非前者。


Mixture of Experts (MoE)
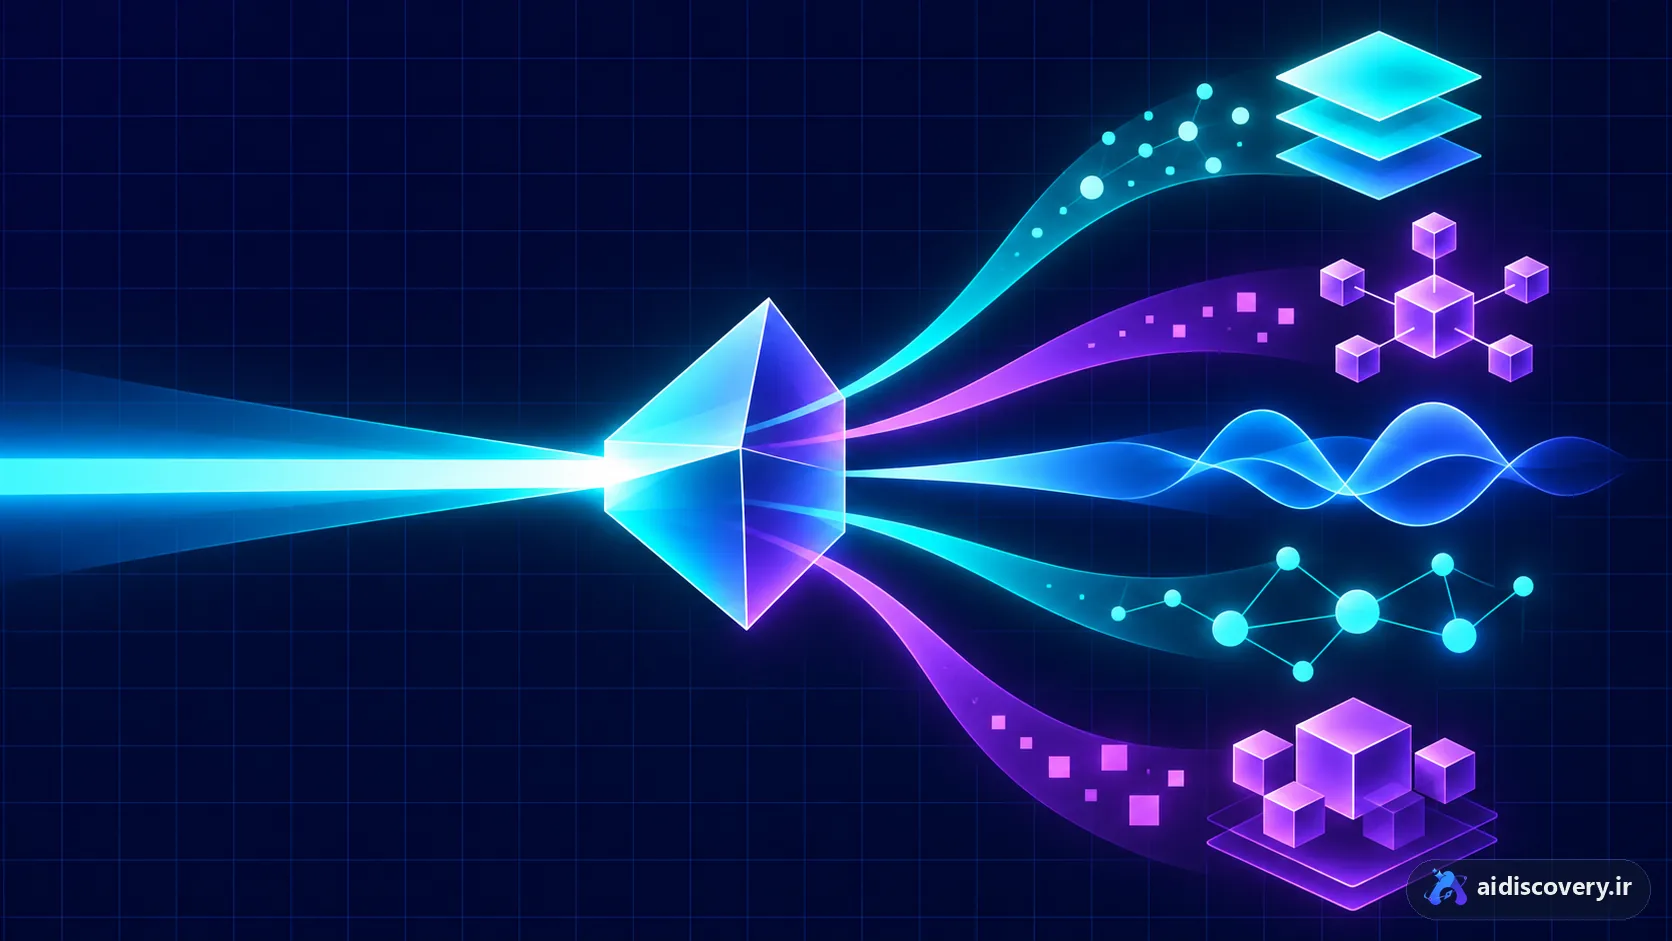
将模型划分为多个「专家」并只激活与输入相关的少数专家的架构——以更低的推理成本获得大得多的模型。
专家混合(MoE)把模型拆成若干部件:多个各管一片知识的「专家」,外加一个路由器,每个输入只唤醒少数相关专家。4000 亿总参数的模型每个词元可能只激活 100 亿。
它的迷人等式是:巨人模型的知识量 + 中等模型的推理成本。这正是它统治 2025–2026 的原因:DeepSeek V3、GPT-4 与 Gemini 都是 MoE。
必须知道的技术细节:「总参数」与「每词元激活参数」是两个不同的数字;比较模型应看后者(以及数据质量),而非前者。